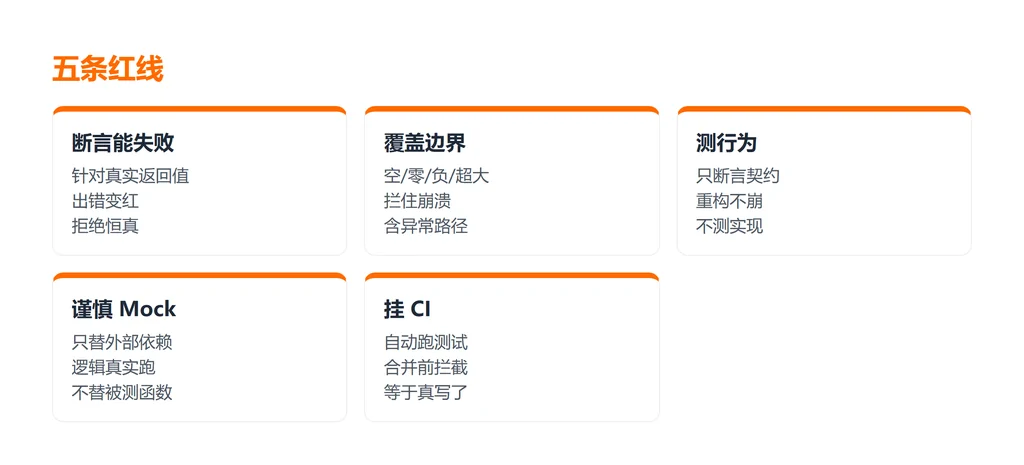
用 DeepSeek 写单元测试想靠谱,核心是先把五件事钉死:断言必须能失败;边界条件要补齐;测行为不测实现;外部依赖谨慎 Mock;测试挂进 CI 自动跑。它确实快,但生成的测试常常齐全好看,却派不上用场:断言永远为真,只测了快乐路径,边界条件一个没覆盖,Mock 乱飞导致测了个寂寞。这些坑不提前想清楚,上线后照样出 bug。(原文有删节)
适用边界先说明:本文以 Python + pytest 为例,思路同样适用于 JUnit、Go test 等;不涉及端到端测试与性能压测,聚焦函数级单元测试。
坑一:断言恒真,测试永远绿
最隐蔽的坑是 DeepSeek 写单元测试时给你一个永远通过的断言,比如先调用再 assert True。这种写法等于没测,因为无论函数返回什么,pytest 都会报 green。
危险写法是 result = add(1, 2) 之后直接 assert True,永远通过,测了个寂寞。正确写法要针对真实返回值断言:assert add(1, 2) == 3,assert add(-1, 1) == 0。
判断标准很朴素:测试应当在 add 返回错误值时立刻变红。如果测试全绿但你改坏函数却没报警,第一反应就是查断言是不是恒真,而不是怀疑框架。
坑二:只测快乐路径,边界条件全空
快乐路径只能证明「正常时可用」,却证明不了「异常时不崩」。边界条件包括空值、零和负数,还有超大数与重复项,这些才是生产环境最容易炸的地方。AI 默认爱写「正常输入」的用例,对边界条件视而不见。
正确做法是把边界写进同一组用例:正常除法断言 10/2 == 5;除零用 pytest.raises(ZeroDivisionError) 断言必须抛异常;再补 0/5 == 0 与 -10/2 == -5。多写几条边界用例成本极低,却能拦住大多数线上崩溃,性价比极高。
一个常见误判是认为「主流程过了就安全」。曾有团队让 AI 生成支付对账测试,只覆盖了正常入账,结果上线后遇到一笔「冲正后又入账」的边界交易,金额直接翻倍却没有任何测试报警。补上这条异常路径后,对账差异才被及时发现。
坑三:Mock 乱飞,测了个寂寞
Mock 用错比不用更糟。常见错误是把被测函数自己也 Mock 了:patch 掉 myapp.fetch_user 之后再断言 fetch_user(1) 的返回值,结论永远成立,因为被测逻辑根本没跑。
正确做法是只 Mock 外部依赖,比如数据库与网络请求,还有第三方 API 和时间函数,让真实逻辑跑起来。例如只 patch myapp.db.get 返回固定字典,然后断言 fetch_user(1)[“name”] 是否符合业务转换结果。
另一个变种是测实现而不是测行为:断言「函数内部调用了某个私有方法」,一旦重构改名测试就崩,可行为其实没变。让 DeepSeek 写单元测试时明确要求「只断言公开返回值与副作用」,能避免这类脆弱测试。它还很爱复制粘贴相似用例,拿到结果后把重复的合并成 pytest 的 parametrize 参数化测试,既精简又覆盖更全。
先想清楚的五个问题
真正用好 DeepSeek 写单元测试,关键是提问前先自问五句,并把这五句写进提示词:
- 我的断言能不能在出错时变红?
- 边界条件(空、零、负、超大、重复)覆盖了吗?
- 我测的是行为还是内部实现?
- Mock 是不是只替了外部依赖?
- 这套测试会挂进 CI 自动跑吗?不挂流水线等于没写。
想验证 DeepSeek 给你的测试是否真有用,最朴素的做法是本地跑一遍:pytest tests/ -q 先确认全绿;接着故意改坏一处函数实现再跑一次,它应当立刻变红。如果改坏了还绿,说明断言或配置有问题,需要回退重写这一组用例,而不是带着假绿灯上线。
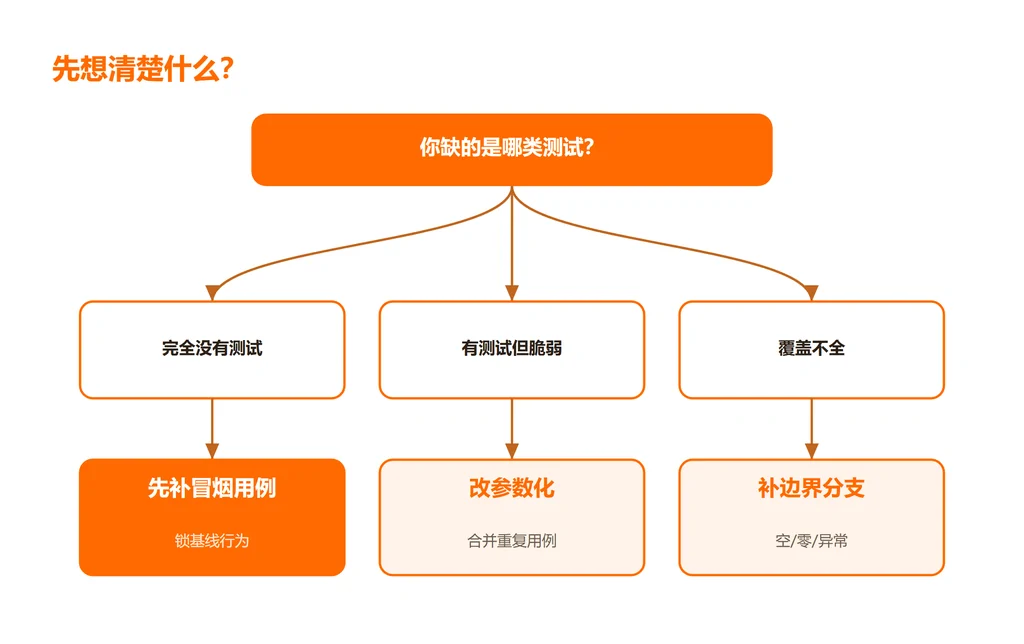
用 DeepSeek 写单元测试想不踩坑,本质是先把五件事想清楚:断言必须能失败;边界条件要补齐;测行为不测实现;外部依赖谨慎 Mock;测试挂进 CI 自动跑。避开断言恒真,只测快乐路径,Mock 乱飞,测实现不测行为,不挂流水线这五个坑,AI 产出的测试才会成为真正的护城河,而不是 green 的假象。
本文转载自编程狮(w3cschool.cn) 《DeepSeek 写单元测试有哪几种常见踩坑,先想清楚再用》,原文链接:https://www.w3cschool.cn/article/21606469.html。版权归原作者所有,如需删除请联系我们。