很多团队引入 AI 后都会问同一个问题:用 DeepSeek 做代码评审,到底比人工差在哪?差距出在能力结构上。DeepSeek 擅长快速扫出语法、空指针和明显的坏味道,却不擅长判断这段业务逻辑是不是满足真实需求。把两者放对位置,代码质量反而更高。
所谓 DeepSeek 代码评审,本质是用大模型把一份 diff 过一遍,给出风格、潜在缺陷和改进建议;人工评审则是开发者之间对设计、风险与可维护性的讨论。两者互补,谁也不能替代谁。AI 兜底规范,人把控意图。(原文有删节)
先看结论:值得用,但只能当第一道关卡
如果你的目标是「在合并前快速兜住低级错误、统一风格,并给新人即时反馈」,DeepSeek 代码评审值得用,而且比人工更省时;如果你的目标是「评估架构取舍、确认业务正确性,以及把控安全边界」,仍然必须靠人工评审。
最小场景可以这样设想:一份 80 行的 PR,改的是订单状态机。你期待它在一分钟内标出「未处理空订单」「魔法数字」「缺少单测」这类问题,并给出修改建议;而「状态机是否多考虑了退款分支」这种需要理解业务的判断,交给 reviewer。明确这个预期很重要,因为它决定了工具边界:AI 评审的输出是线索清单,不是裁决。
把评审拆成「机器能做的」和「人必须做的」两层,是落地 AI 评审的第一步。很多团队一开始把 AI 的输出当圣旨,后来发现它在某些业务判断上还不如实习生,于是又彻底弃用,两种极端都不可取。正确的做法是先承认它的能力边界,再把它放到擅长且低风险的环节。
最稳的用法:人工 review 之前先跑一遍
让 DeepSeek 在人工评审之前先过一遍,过滤掉机械问题,人工 reviewer 拿到的就是一份「去噪后的代码」,可以把精力放在设计层面。可以直接用下面这段提示词:
请评审以下 diff:1) 列出语法/空指针/异常处理问题;2) 指出不变量与边界未覆盖处;3) 给出最小改动建议。不要重写业务,只给问题清单。
提示词里「只给问题清单、不要重写业务」这句约束很关键。一旦允许模型直接改代码,它容易为了「看起来更完美」而顺手重构你没让它碰的逻辑,反而引入新风险。让 AI 止于「指出问题」,把「怎么改」的决定权留在人手里,是这套流程能长期跑通的前提。
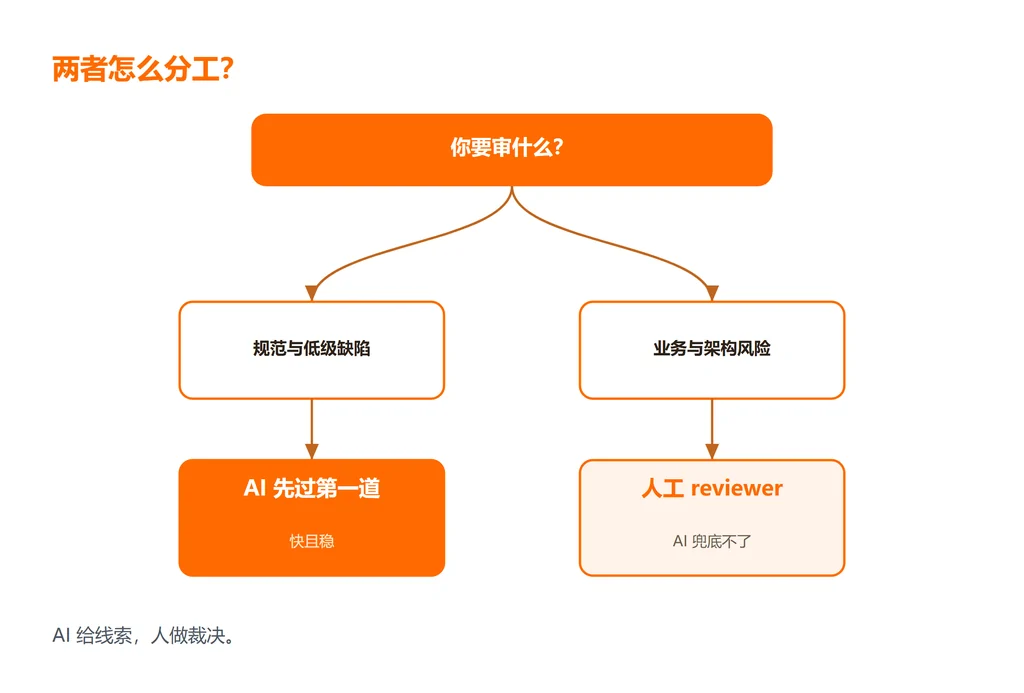
三种场景,三种配比
不同评审场景,AI 与人力的配比并不相同。
- 批量规范检查(命名、格式、明显坏味道):规则清晰、可枚举,DeepSeek 比人快且稳定,适合作为必过卡点。
- 业务逻辑与架构评审:AI 缺乏项目全局上下文,容易「局部正确、整体跑偏」,最终判断权必须留给人。
- 安全与合规评审:涉及权限、加密、隐私的改动,AI 可能漏掉隐蔽风险,必须有人复核。
配比多少才算合理,取决于团队成熟度。新人占比高的团队,可以让 AI 多承担规范检查,给新人即时反馈、减少 reviewer 的重复劳动;核心业务改动密集时,则应该把 AI 的结果仅作为参考、人工评审占主导。评审重在把对的判断放到对的人手上,数量不是关键。
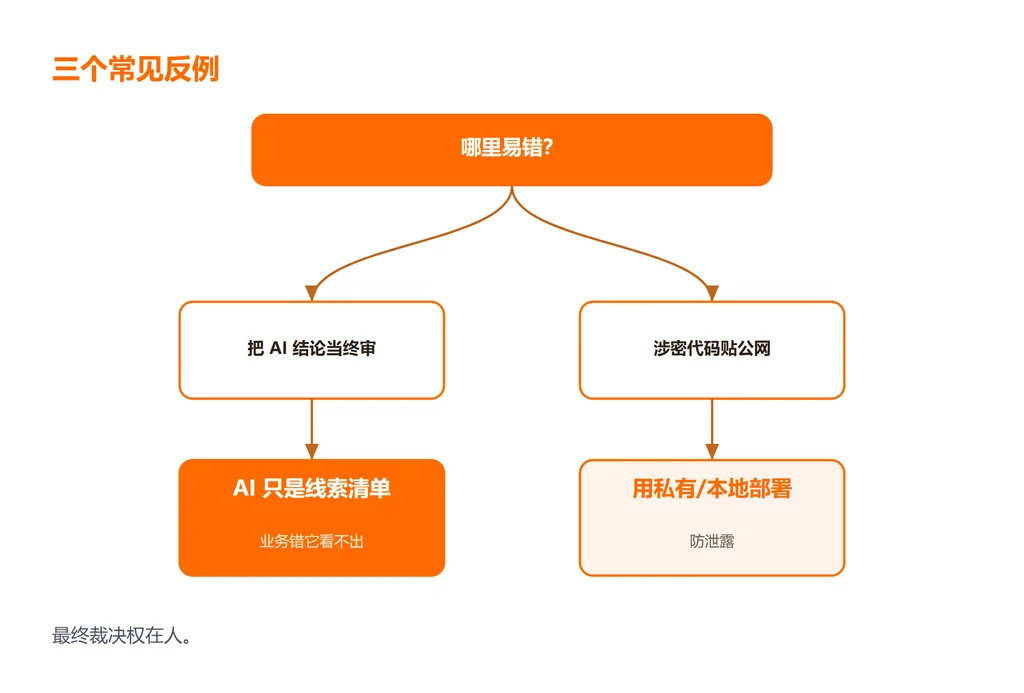
三个最容易踩的坑
坑一:把 AI 评审结论当终审。有人直接按模型建议合并,结果引入「语法正确但业务错误」的改动。AI 看不懂你没说的需求。
坑二:喂给模型的上下文太少。只给 diff 不给背景,DeepSeek 只能做字面检查,连「这个字段为什么不能为空」都不知道。必要时补一段需求说明。
坑三:用通用大模型做涉密代码评审,造成源码外泄。内部代码不应随便贴到公网模型,涉密项目优先考虑本地化或企业私有部署的评审能力,并且只提供必要上下文。
还有一点容易被忽略:AI 评审会给出「置信度很高」的语气,但语气不等于正确。遇到它用非常肯定的口吻指出某个「问题」时,先去代码里核实,而不是立刻照改。把 AI 的每条意见都当成「待验证的假设」,评审质量反而会提升。
动手验证清单
- 准备:本地备一份示例 diff 与一个 DeepSeek 会话。
- 运行:把提示词与 diff 一起提交,观察返回的问题清单。
- 检查:清单应覆盖空值、异常、边界,而不是重写业务。
- 验证:找一段「语法正确但业务错」的代码,确认 AI 是否会误判为通过。
- 失败处理:若 AI 频繁误报,收紧提示词,限定「只列问题不修改」。
DeepSeek 代码评审和人工评审谁也取代不了谁,能力结构互补:AI 擅长快速、稳定地兜住规范与低级缺陷,人擅长判断业务正确性与架构风险。把它放在人工 review 之前做第一道关卡,既能省时间,又能让 reviewer 聚焦真正需要判断力的地方。记住,AI 给的是线索清单,最终裁决权永远在人。
本文转载自编程狮(w3cschool.cn) 《用 DeepSeek 做代码评审对比人工差在哪?该用还是别用》,原文链接:https://www.w3cschool.cn/article/18184874.html。版权归原作者所有,如需删除请联系我们。